Mientras los modelos de lenguaje convencionales generan tokens de texto en un plano puramente abstracto, los modelos Vision-Language-Action (VLA) representan el salto hacia la inteligencia encarnada en el mundo físico. Desarrollos pioneros como pi0 de Physical Intelligence han demostrado que una única red neuronal fundacional puede procesar lenguaje natural, imágenes sensoriales y generar directamente trayectorias cinemáticas continuas de alta precisión en diversos tipos de robots sin necesidad de programación ad-hoc.
¿Cómo opera un modelo VLA? Del píxel al vector de torque
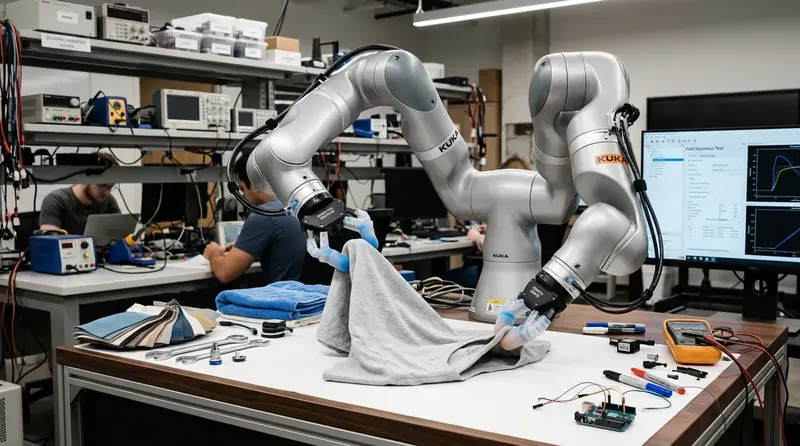
La arquitectura de un modelo VLA unifica un codificador visual masivo (Vision Transformer), un modelo de lenguaje autorregresivo y una cabeza de generación de acciones basada en Flow Matching o difusión de trayectorias. Al recibir una instrucción en lenguaje natural (ej. "dobla la playera por la mitad y colócala en la caja"), el modelo proyecta la meta semántica sobre el mapa visual del entorno tridimensional.
En lugar de dividir la tarea en pasos lógicos preprogramados (detectar objeto, calcular cinemática inversa, abrir pinza), la red infiere directamente la densidad de probabilidad de las velocidades y torques de cada articulación motora a una frecuencia de 50 Hz, permitiendo un control reactivo y continuo ante perturbaciones físicas imprevistas.
- Arquitectura fundacional: Fusión de Vision Transformers (ViT) preentrenados y cabezas de acción continua basadas en Flow Matching.
- Generalización multi-robot: Capacidad del modelo pi0 para operar simultáneamente sobre brazos manipuladores UR5, bípedos y robots móviles sin reentrenamiento estructural.
- Tolerancia a la deformación: Manipulación exitosa de materiales blandos (ropa, cables, bolsas de plástico) que antes resultaban intratables con visión tradicional.
- Entrenamiento híbrido: Combinación de millones de datos sintéticos de simulación con datasets de teleoperación humana en el mundo real.
"Lo vi en AI Robot: El modelo VLA es el verdadero puente que une el razonamiento cognitivo con las leyes inviolables de la física newtoniana."
Flow Matching y la generación fluida de trayectorias
Uno de los grandes avances de pi0 sobre modelos VLA anteriores (como RT-2 o Octo) es el reemplazo de la discretización de acciones por modelos generativos de Flow Matching. Esto elimina la lentitud del muestreo por difusión clásico y permite generar bloques completos de acción en apenas 15 milisegundos, dotando al robot de una respuesta háptica casi instantánea.
Esta fluidez se traduce en una destreza equiparable a la humana en tareas domésticas e industriales complejas: desde anudar bolsas de basura y ensamblar cajas de cartón hasta manipular vajillas delicadas y clasificar piezas electrónicas minúsculas.
El futuro de los sistemas abiertos en aprendizaje robótico
Con iniciativas abiertas como Open X-Embodiment y LeRobot de Hugging Face, la comunidad global de investigadores está acelerando la disponibilidad de datasets públicos de entrenamiento. El modelo VLA se perfila como el estándar de software que impulsará la próxima generación de robots de servicio, manufactura y asistencia personal en todo el mundo.
🔗 Recursos y Enlaces Recomendados para Profundizar
- Physical Intelligence Research Blog ↗ — Publicaciones técnicas y demostraciones de manipulación con el modelo fundacional pi0.
- Hugging Face LeRobot Library ↗ — Repositorio abierto de modelos, datasets y scripts para aprendizaje por imitación y VLA.
- ArXiv Robotics (cs.RO) ↗ — Archivo de preprints y papers de investigación en frontera de inteligencia artificial física.